1. 变量与函数#
我们先从最核心的部分开始——变量类(Variable)。 还记得 PyTorch 和 TensorFlow 吗?它们的底层核心都是 Tensor。在我们的实现中,也会有类似的概念,只不过底层我们用的是 numpy.ndarray。所有的运算都基于它来完成。 那问题来了:既然 NumPy 已经能做广播、求和、矩阵乘法这些操作,为什么还要自己再封装一层“变量类”呢? 确实,用 NumPy 我们也能写出各种计算,但它有一个致命的限制——NumPy 不会记录你的计算过程。也就是说,它不知道你是怎么一步步算出结果的,更别提反向传播或者自动求导了。 而我们定义“变量类”的意义就在这里。它不只是一个装数据的容器,而是一个能“记住”自己经历过哪些运算的智能变量。有了它,我们就能自动构建计算图,实现一系列自动化的操作,比如梯度计算、参数更新等等。
import numpy as np

class Variable:
    def __init__(self, data):
        self.data = data

data = np.array(1.0)
x = Variable(data)
print(x.data)接下来,我们来看一看函数这一块。 先抛个问题:什么是函数? 比如这算不算函数?当然算!这是一个最基础的形式——从一个变量映射到另一个变量。 不过,现实中我们经常会遇到更复杂的函数。比如 sum(),它的输入是多个值,输出却是一个值,这就属于多对一的函数。而且这类函数通常还涉及到数据维度的变化,稍微麻烦一点,我们后面再慢慢讲。现在,我们先从简单的单变量函数入手。 前面我们说过,定义“变量类”的目的,是为了能记录计算过程。那同理,如果我们想要整个计算图完整、可追踪,函数的计算过程也得被“记住”。这意味着什么?——函数也要被实例化! 不过,函数有很多种:平方、加法、乘法、求和、指数……每一种都有自己的逻辑。如果一个个单独写,那代码会一团糟。 因此我们需要定义一个函数的父类(Function),然后让各种具体运算(eg. Add、Mul、Square )去继承它:
import numpy as np

class Variable:
    def __init__(self, data):
        self.data = data

class Function:
    def __call__(self, input):
        x = input.data
        y = self.forward(x)
        output = Variable(y)
        return output

    def forward(self,x):
        raise NotImplementedError

class Square(Function):
    def forward(self, x):
        return x ** 2

def square(x):
    return Square()(x)

if __name__ == "__main__":
    import numpy as np
    x = Variable(np.array(6))
    y = square(x)
print(y.data)解释一下:call 是一个特殊方法,允许一个对象像函数一样被调用。怎么说呢?等价于隐藏了.call()函数,然后使用y = square(x)的时候,先调用了Square里从Function那里继承来的__call__,再利用call内部的forward执行自己的forward。 有一个需要注意的是,我们说过,ndarray执行的是计算功能,所以,定义函数时候的forward的输入不是Variable类型,而是ndarray类型。而执行函数的时候还是输入Variable类型。 还有就是,定义square(x)函数的主要目的是符合我们的习惯,这样可以不用定义两个括号。
2. 纯链式正向传播与反向传播#
对于正向传播,其实我们只需要这么做就行了:square(square(square(x)))不就得了,这样就能很自然地一层一层执行下去…当然,也不一定是square函数,这里只是举个例子,其实换成其他的也行,比如add(exp(x)+exp(y))。
然后我们来研究一下反向传播。
首先,先提出一个概念,叫做计算图,我们之前提到过,它可以长这样:
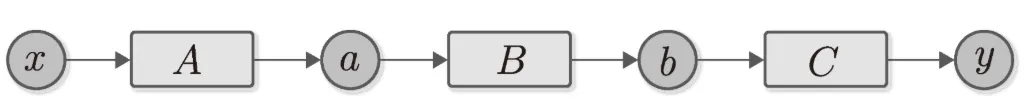
假如我们拥有变量y,并且要对x求导的话,由链式法则,有:,即:
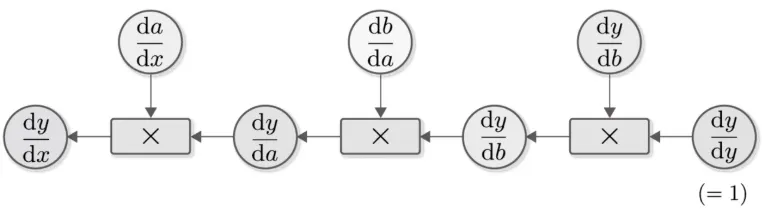
我们把叫做梯度,在Variable类里添加grad这个属性,类型是ndarray,这一点我相信大家并不会陌生。 首先明确一件事情,我们需要知道什么才能计算梯度?我们知道前向过程的输入的变量。举个例子,知道之后,就能知道了。所以我们需要在Fuction类中添加input属性加以记录就行,然后此次算出来乘起来就行,Fuction的每个函数添加一个backword方法计算。 接下来就是,怎样记录这个计算图?从刚刚的反向传播的步骤我们不难知道这是一个类似链表一样的东西,把变量和函数都视作节点,记住它们的前驱就行了!所以现在你可以回答Fuction类中input属性是什么了,没错,是Variable类型。同理,我们需要记住变量的前驱,在Variable类型里添加creator属性就行,同理,这个属性的类型是函数类型。 我们还有一件事,假如我们顺利地处理出了所有的梯度,但是我们最后要求的可不只是每个的梯度,还有它们梯度的乘积,所以为了把“后面的变量的梯度”传递到前面,我们再给Fuction类添加一个output属性,这样后面的grad就能自然的在反向的时候向前推动了。 对于y = square(exp(square(x)))我们能轻松实现这一过程:
import numpy as np

class Variable:
    def __init__(self, data):
        self.data = data
        self.grad = None
        self.creator = None

    def set_creator(self, func):
        self.creator = func

    def backward(self):
        if self.grad is None:
            self.grad = np.ones_like(self.data)

        funcs = [self.creator]
        while funcs:
            f = funcs.pop()
            x, y = f.input, f.output
            x.grad = f.backward(y.grad)

            if x.creator is not None:
                funcs.append(x.creator)

def as_array(x):
    if np.isscalar(x):
        return np.array(x)
    return x

class Function:
    def __call__(self, input):
        x = input.data
        y = self.forward(x)
        output = Variable(as_array(y))
        output.set_creator(self)
        self.input = input
        self.output = output
        return output

    def forward(self, x):
        raise NotImplementedError()

    def backward(self, gy):
        raise NotImplementedError()


class Square(Function):
    def forward(self, x):
        y = x ** 2
        return y

    def backward(self, gy):
        x = self.input.data
        gx = 2 * x * gy
        return gx


class Exp(Function):
    def forward(self, x):
        y = np.exp(x)
        return y

    def backward(self, gy):
        x = self.input.data
        gx = np.exp(x) * gy
        return gx


def square(x):
    return Square()(x)


def exp(x):
    return Exp()(x)


x = Variable(np.array(0.5))
y = square(exp(square(x)))
y.backward()
print(x.grad)3. 可变数参数#
前面我们研究的是链式的计算图,接下来我们研究一下多链式图(即“相对链式”,输入之后就是输出的那种图,但是输入和输出参数的数量会变,即“可变的长参数”,无需考虑拓扑序的那种)。
- 前向过程: 我们来解决一下上面没有解决的问题,也就是add函数,它接受两个输入,但是只返回一个输出!这种函数是存在的。那么,有没有一个输入两个输出的呢?答案是,这也存在。比如把一个矩阵分成两个小矩阵的函数,甚至分成几个相同的矩阵也不是不行。也存在多对多的情况,比如MLP!所以说,我们需要把Function的input和output处理成inputs和outputs。 其实这不难理解,无非就是添加了一个循环而已。不过需要注意的是,我们为了形式上的统一,把单变量也按照列表管理处理,也就是说,内部的流动不存在单个的形式,都有一定的维度,但是输入和输出允许单个,方便我们的习惯。
- 反向过程: 我们的backword函数里,需要进行调整,局部的函数也需要进行调整。 gys是函数是输出层的所有的变量的梯度,利用它们可以“计算”出函数输入层的梯度(这里的“计算”指的是融合,实际上局部梯度只需要函数本身和输入层就够了)。同样道理的,假如gxs是输出维度只有一层就给它套个壳(之前规范过),然后把输入层和输入层的梯度对应上就行了。对应部分的判断主要是应对这种情况:y=add(x, x)。那为啥不初始化为0,直接执行递增呢?设置为None可以节约空间啊!还有一件事,就是,由于py底层问题,此处最好不要使用自加函数哈,会不稳定。
import numpy as np


class Variable:
    def __init__(self, data):
        if data is not None:
            if not isinstance(data, np.ndarray):
                raise TypeError('{} is not supported'.format(type(data)))

        self.data = data
        self.grad = None
        self.creator = None

    def set_creator(self, func):
        self.creator = func

    def cleargrad(self):
        self.grad = None

    def backward(self):
        if self.grad is None:
            self.grad = np.ones_like(self.data)

        funcs = [self.creator]
        while funcs:
            f = funcs.pop()
            gys = [output.grad for output in f.outputs]
            gxs = f.backward(*gys)
            if not isinstance(gxs, tuple):
                gxs = (gxs,)

            for x, gx in zip(f.inputs, gxs):
                if x.grad is None:
                    x.grad = gx
                else:
                    x.grad = x.grad + gx

                if x.creator is not None:
                    funcs.append(x.creator)


def as_array(x):
    if np.isscalar(x):
        return np.array(x)
    return x


class Function:
    def __call__(self, *inputs):
        xs = [x.data for x in inputs]
        ys = self.forward(*xs)
        if not isinstance(ys, tuple):
            ys = (ys,)
        outputs = [Variable(as_array(y)) for y in ys]

        for output in outputs:
            output.set_creator(self)
        self.inputs = inputs
        self.outputs = outputs
        return outputs if len(outputs) > 1 else outputs[0]

    def forward(self, xs):
        raise NotImplementedError()

    def backward(self, gys):
        raise NotImplementedError()


class Add(Function):
    def forward(self, x0, x1):
        y = x0 + x1
        return y

    def backward(self, gy):
        return gy, gy


def add(x0, x1):
    return Add()(x0, x1)

x = Variable(np.array(3.0))
y = add(add(x, x), x)
y.backward()
print(x.grad)4. True计算图#
其实上一节的假设不太好,我们这里直接引入复杂的计算图吧。计算图的本质上是一个DAG(有向无环图),对于一个DAG,给定起点,一定可以进行拓扑排序。拓扑排序的做法有很多种,比如kahn算法抑或是染色法,我们这里使用Kahn算法,但是不完全是Kahn,个人感觉只是使用了Kahn 算法中的“层次”概念。不了解的自己去搜或者尝试证明以下的方法。
假如我需要处理下面这个图,我们之前的方法可能会y→D→c→C→a→A→x…这样是错的,因为处理a一直到x的时候,b和B都没处理,显然和计算顺序不符。
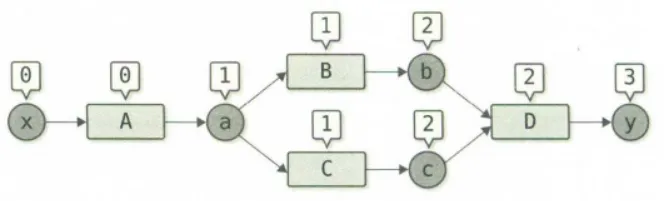 所以我们使用这个方法:
我们给每个Function还有Variable添加一个generation参数,然后我们在正向传播的时候,假如现在是函数,那么它的输出变量的generation为函数的generation+1。有人可能会问,直接赋值不会受到其他函数的干扰吗?要记住,一个变量只能由一个函数生成!所以不会干扰。函数的generation为它的所有输出层变量的generation的max。具体怎么挑下一个要处理的函数呢?取最大的generation的处理就行了。
理论上,只需要每个Function有 generation就行了,不过为了方便,我们给变量赋值上generation可以利用计算图的完整性,方便执行。
import numpy as np


class Variable:
    def __init__(self, data):
        if data is not None:
            if not isinstance(data, np.ndarray):
                raise TypeError('{} is not supported'.format(type(data)))

        self.data = data
        self.grad = None
        self.creator = None
        self.generation = 0

    def set_creator(self, func):
        self.creator = func
        self.generation = func.generation + 1

    def cleargrad(self):
        self.grad = None

    def backward(self):
        if self.grad is None:
            self.grad = np.ones_like(self.data)

        funcs = []
        seen_set = set()

        def add_func(f):
            if f not in seen_set:
                funcs.append(f)
                seen_set.add(f)
                funcs.sort(key=lambda x: x.generation)

        add_func(self.creator)

        while funcs:
            f = funcs.pop()
            gys = [output.grad for output in f.outputs]
            gxs = f.backward(*gys)
            if not isinstance(gxs, tuple):
                gxs = (gxs,)

            for x, gx in zip(f.inputs, gxs):
                if x.grad is None:
                    x.grad = gx
                else:
                    x.grad = x.grad + gx

                if x.creator is not None:
                    add_func(x.creator)
def as_array(x):
    ......

class Function:
    def __call__(self, *inputs):
        xs = [x.data for x in inputs]
        ys = self.forward(*xs)
        if not isinstance(ys, tuple):
            ys = (ys,)
        outputs = [Variable(as_array(y)) for y in ys]

        self.generation = max([x.generation for x in inputs])
        for output in outputs:
            output.set_creator(self)
        self.inputs = inputs
        self.outputs = outputs
        return outputs if len(outputs) > 1 else outputs[0]
......seen_set的意思是,目前添加过哪些函数,就不能二次添加了。每次添加函数之后进行一轮sort,看似复杂度爆炸,实则模型里的函数数目其实比变量少多了,这点复杂度不需要节约,加个优先队列反而需要占用更多空间。
5. 一些必要的优化#
- 内存管理和循环引用
Python使用两种方式管理内存,一种是引用计数,另外一种是分代垃圾回收。引用计数的原理很简单,当它被另一个对象引用的时候,引用计数+1,停止引用时,引用计数-1。引用计数为0时,Python解释器会回收该对象。这很智能,但是它不能处理循环引用,所以单纯设置None无法解决这个内存问题。不过分代垃圾回收机制可以解决这个问题,具体原理很复杂这里不多说了。他会在内存不足的时候自动调用,也可以gc.collect()主动调用。 在 Python 中,我们可以使用 weakref.ref 函数来创建弱引用。弱引用是在不增加引用计数的情况下引用另一个对象的功能。我们需要破除右侧的循环,可以给outputs打上weakref,就可以自动破除了。weakref的引用方式是后面加个”()”。
while funcs:
    f = funcs.pop()
    gys = [output().grad for output in f.outputs]  # output is weakref
    ......
        if x.creator is not None:
            add_func(x.creator)
    ......
    class Function:
    def __call__(self, *inputs):
        ......
        self.inputs = inputs
        self.outputs = [weakref.ref(output) for output in outputs] # output is weakref
return outputs if len(outputs) > 1 else outputs[0]- 自动消除不必要的内存
- 一、在反向传播的时候,中间用过的梯度,在很多情况下,可以不要了。
- 二、我们知道,pytorch里,有个功能是model.train(),还有功能是model.eval()。这两个的区别之一就是后者不需要保留中间层的输入变量。 对于第一点,我们可以在backword函数处设置一个开关,自主选择是否需要中间的梯度: 对于第二点,可以使用@contextlib.contextmanager修饰器,它可以让你用 生成器函数 来实现 with 语句的行为,实现“在局部时间”内的控制操作。
- 添加一些同步化的优化 有一点需要明确,虽然我们使用了numpy的ndarray作为计算底层,那么我们为何不整一个numpy-plus呢?简单来说,我们可以添加一些函数让它更加易用! numpy里有个东西叫做x.shape,这里我们实现一下:
@property
def shape(self):
return self.data.shapedtype,ndim,size同理,len可以重载__len__实现,print可以重载__repr__实现,这里不赘述了,包括运算符的重载。 有个需要注意的是,由于函数是实例化的,它可以存东西。这一点很重要,后续的矩阵运算也依赖维度的信息存储。比如幂函数:
class Pow(Function):
    def __init__(self, c):
        self.c = c
    def forward(self, x):
        y = x ** self.c
        return y
    def backward(self, gy):
        x = self.inputs[0].data
        c = self.c
        gx = c * x ** (c - 1) * gy
        return gx
def pow(x, c):
    return Pow(c)(x)
Variable.__pow__ = pow原书有绘制计算图以及求高阶导数等步骤,在这里我们将掠过,这部分内容不需要。
6. 可变长参数#
前面我们研究过“可变数参数”,这是啥意思呢?通俗的说就是,输入和输出的变量数目不一样,比如add,会把两个变量聚合到一个变量上面去。这里我们讲的可变长参数的主要是,变量内部的维度。比如sum函数,它可以把一个1*n长度的变量变成一个标量,对应的,它的正向传播和反向传播也得写清楚,还有更难的,比如矩阵呢?这个在接下来我们会一步一步讲。
- reshape函数 这个函数比较容易理解,所以我打算把它放在最开始去讲。 回忆一下,我们之前讲幂次函数的时候,我们说过,要记录一个东西是吧,也就是幂次本身。我们的reshape函数同理,要记录一下原来的维度(x_shape)以及改变后的维度(shape)。numpy里自带了reshape函数,所以计算过程直接使用就行。对于反向过程,我们直接reshape回去就行,梯度数值不需要进行处理。
class Reshape(Function):
    def __init__(self, shape):
        self.shape = shape

    def forward(self, x):
        self.x_shape = x.shape
        y = x.reshape(self.shape)
        return y

    def backward(self, gy):
        return reshape(gy, self.x_shape)

def reshape(x, shape):
    if x.shape == shape:
        return as_variable(x)
return Reshape(shape)(x)使用方法比较反人类:y = F.reshape(x,(6,)),而我们平时可能使用惯了y = x.reshape(2, 3)这样,所以我们可以修改一下Variable类,去实现这个便捷设计(略)。
- 矩阵乘法
求导: 设定: 令其中,,上游标量损失为L,并记梯度矩阵。 则,。 推导: 每个元素: 用链式法则:
= \sum_{i,j} G_{ij}\,\delta_{iu}\,B_{vj} = \sum_{j} G_{uj} B_{vj},$$ 这就是矩阵形式 $$\frac{\partial L}{\partial A} = G B^{\mathsf{T}}.$$ 对 B 同理: $$\frac{\partial L}{\partial B_{uv}} = \sum_{i,j} \frac{\partial L}{\partial Y_{ij}} \frac{\partial Y_{ij}}{\partial B_{uv}} = \sum_{i,j} G_{ij}\,A_{iu}\,\delta_{jv} = \sum_{i} A_{iu} G_{iv},$$ 因此矩阵形式为 $$\frac{\partial L}{\partial B} = A^{\mathsf{T}} G.$$ 故矩阵乘法就很简单了: ```python class MatMul(Function): def forward(self, x, W): y = x.dot(W) return y def backward(self, gy): x, W = self.inputs gx = matmul(gy, W.T) gW = matmul(x.T, gy) return gx, gW def matmul(x, W): return MatMul()(x, W) ```